一、算术运算符与表达式
1、表达式
C 语言中的运算符可以对操作数执行运算。 但表达式不仅仅是为了计算数值,还可能产生副作用(Side Effect)。
int a = 10;

a + 1;
a++;
a = 20;
表达式 | 表达式的值 | 是否修改 a |
|---|---|---|
| 11 | 否 |
| 10 | 是,a 变为 11 |
| 20 | 是,a 变为 20 |
表达式的值(Value):表达式求值产生的结果。 副作用(Side Effect):表达式求值过程中,除了计算结果以外,还发生了其他可观察的操作,例如修改对象、执行 I/O 等。
考虑:
int a = 10;
int b = a++;最终b = 10,a = 11。 a++ 这个表达式的值是修改前的 a,同时还产生将 a 增加 1 的副作用。
2、前置自增与后置自增
对于变量 a:
++a;  // 前置自增
a++;  // 后置自增
两者都会使
a增加 1,区别在于表达式的值。
表达式 | 表达式的值 | 执行后的 a |
|---|---|---|
| 增加后的值 | 原值 +1 |
| 增加前的值 | 原值 +1 |
| 减少后的值 | 原值 -1 |
| 减少前的值 | 原值 -1 |
示例:
int a = 5;

int b = a++;
int c = ++a;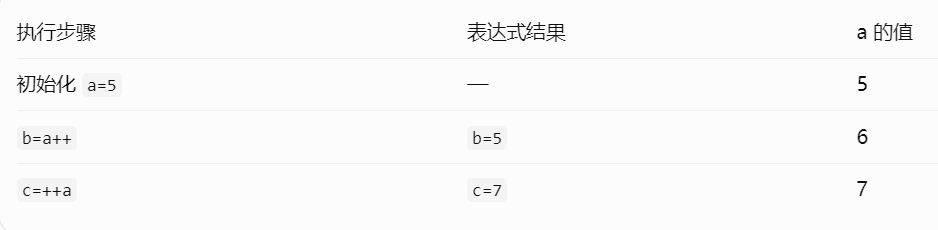
3、算术运算中的除法与取模 从 C99 开始,整数除法==向零截断==。 满足:
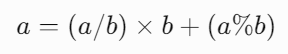
“向零截断”指的是:整数除法得到的商,把小数部分直接丢掉,使结果朝 0 的方向靠拢。不是四舍五入,也不是向下取整。
比如: -7 / 3 数学精确值:-7 ÷ 3 = -2.333... 这个结果在数轴上位于 -3 和 -2 之间:
-3        -2.333...        -2        0
|-----------|--------------|---------|向零截断:朝
0的方向取整数,得到-2向下取整:朝更小的方向取整数,得到
-3四舍五入:得到
-2C 语言整数除法采用向零截断,所以:-7 / 3 == -2
表达式 | 整数商 | 余数 |
|---|---|---|
| 2 | 1 |
| -2 | -1 |
| -1 | 1 |
| 2 | 1 |
在 C99 及以后,整数 % 的非零结果与左操作数(被除数)具有相同的符号。
4、表达式的值和最终变量值不一定相同
考虑:
int a = 10;
int b = (a += 5);
结果:
a == 15;
b == 15;
赋值运算符 = 不只是修改变量,赋值表达式本身也产生一个值。 需要注意的是,C 语言中的赋值表达式并不因此成为左值。
二、关系运算符与逻辑运算符
1、关系运算符
运算符 | 含义 | 示例 |
|---|---|---|
> | 大于 |
|
< | 小于 |
|
>= | 大于等于 |
|
<= | 小于等于 |
|
== | 等于 |
|
!= | 不等于 |
|
C 语言中,关系运算和相等性比较的结果类型是 int,结果为 0 或 1。
C 语言并不支持数学式的连续比较,如0<a<10
2、逻辑运算符
主要有三个逻辑运算符
运算符 | 名称 | 含义 |
|---|---|---|
| 逻辑与 | 两边都为真,结果才为真 |
|| | 逻辑或 | 至少一边为真,结果就为真 |
| 逻辑非 | 对真假取反 |
0表示假。非零值表示真。
逻辑运算符的结果是
int类型的0或1。
3、短路求值(Short-Circuit Evaluation)
(1)逻辑与 && 的短路求值
考虑:
int a = 0;
int b = 10;

if (a != 0 && b / a > 2)
{
    printf("true");
}
存在一个潜在问题: 对于 b / a,如果 a = 0,会发生除零。但本代码中不会执行除零运算。 因为 && 具有短路求值特性。 判断 a != 0 → 结果为假(0)→ 跳过右侧表达式(b / a > 2 不会执行)
(2)逻辑或 || 的短路求值
考虑:
int a = 1;
int b = 0;

if (a || ++b)
{
    printf("true");
}
因为 a 已经为真,整个逻辑或表达式必然为真,因此 ++b 根本不会执行。
短路求值不仅影响表达式的结果,还可能影响程序中变量的最终值。`
(3)短路求值在工程中的应用
void process_data(int *p)
{
    if (p != NULL && *p > 0)
    {
        printf("Valid data\n");
    }
}
p != NULL && *p > 0该写法先判断指针是否为空。 当 p == NULL 时,&& 发生短路,不会执行 *p。
如果改为:
*p > 0 && p != NULL先执行 *p。 如果 p 为 NULL,解引用空指针就会产生未定义行为。
三、位运算符、移位运算与位掩码
1、六种位运算符
运算符 | 名称 | 主要作用 | 示例 |
|---|---|---|---|
| 按位与 | 两位都为1,结果才为1 |
|
| | 按位或 | 至少一位为1,结果为1 | a | b |
| 按位异或 | 两位不同,结果为1 |
|
| 按位取反 | 每个位取反 |
|
| 左移 | 二进制位向左移动 |
|
| 右移 | 二进制位向右移动 |
|
位运算主要作用于整数类型。对于 uint8_t、uint16_t 等较小整数类型,计算前通常还会发生前面学过的整数提升。
2、按位与、或、异或
假设:
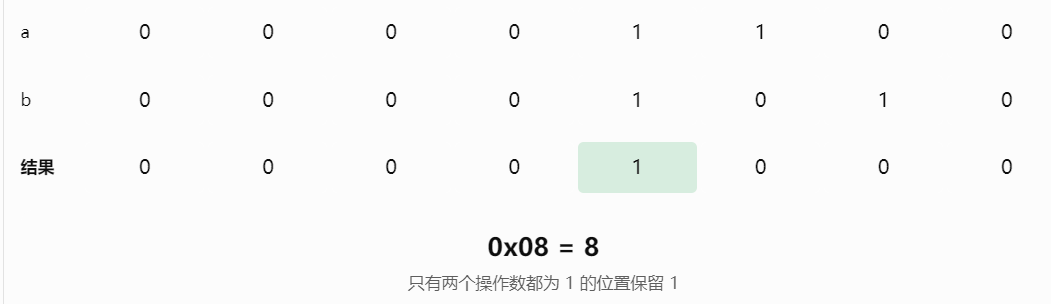
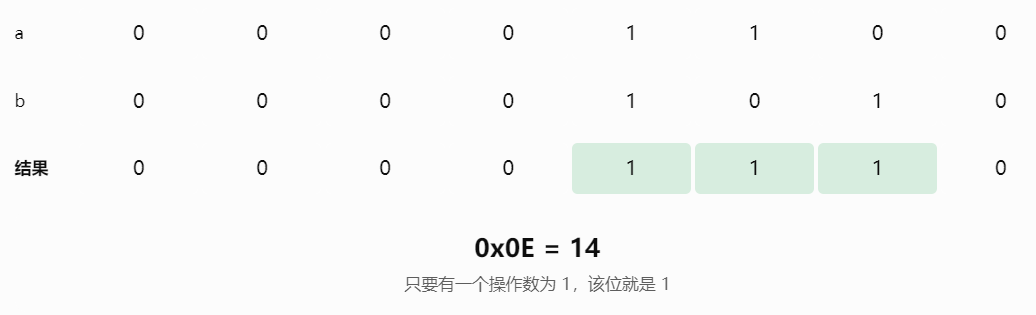
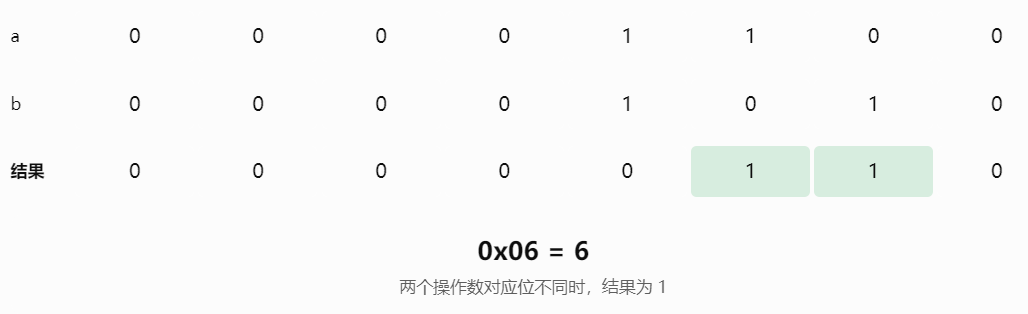
uint8_t a = 0x0C;  // 0000 1100
uint8_t b = 0x0A;  // 0000 1010
(1)按位与&
(2)按位或 |
(3)按位异或
3、位掩码(Bitmask)
位掩码是利用二进制的不同位**表示不同信息**。 例如,一个 8 位状态变量:
uint8_t flags = 0;规定如下:
位编号 | 状态含义 |
|---|---|
bit 0 | 设备已连接 |
bit 1 | 数据已准备好 |
bit 2 | 发生错误 |
bit 3 | 正在运行 |
可以定义:
#define FLAG_CONNECTED (1U << 0)
#define FLAG_READY     (1U << 1)
#define FLAG_ERROR     (1U << 2)
#define FLAG_RUNNING   (1U << 3)
这里的 1U 是无符号整数常量 1。 左移运算1U << 2相当于把二进制的 1 向左移动两位。
0000 0001
       ↓ 左移两位
0000 0100 // `FLAG_ERROR` 的值为 4常用的四种操作: 假设要操作 bit 2 ① 置位:将 bit 2 设置为 1
flags |= (1U << 2);② 清零:将 bit 2 设置为 0
flags &= ~(1U << 2);③ 翻转:将 bit 2 的值反转
flags ^= (1U << 2);④ 检查:判断 bit 2 是否为 1
if ((flags & (1U << 2)) != 0U)
{
    // bit 2 已置位
}
flags & (1U << 2)运算结果可能是 4,而不是 1。 它只是作为逻辑条件时会被解释为真。因此,如果需要标准化的 0 或 1,可以写:
int is_error = ((flags & FLAG_ERROR) != 0U);4、左移与右移运算
对于无符号整数,在移位数量合法的前提下:
uint32_t a = 5;

uint32_t b = a << 2;
uint32_t c = a >> 1;
5 = 0000 0101
左移两位:0001 0100 = 20
右移一位:0000 0010 = 2对于无符号整数:
左移 n 位相当于乘以 (2^n),结果按类型位宽取模。
右移 n 位相当于除以 (2^n),舍弃余数。
符号左移存在风险
int32_t a = 1;
int32_t b = a << 31;
在 C17 等常用标准的规则下,这样的有符号左移需要特别谨慎:左移结果的含义与可表示性受标准规则约束,不能把它简单视作普通乘法。 在进行位掩码操作时,更推荐使用无符号整数:
uint32_t mask = 1U << 31;在 unsigned int 为 32 位的常见平台上,结果为:0x80000000U
移位的位数必须满足:
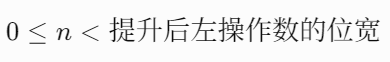
例如,如果 unsigned int 是 32 位,1U << 32就是未定义行为。
有符号右移 对于负数:
int a = -8;
int b = a >> 1;
在 C17 等较早标准下,结果取决于实现,常见平台会执行算术右移,得到 -4。 因此在需要明确位级行为的代码中,优先使用适当的无符号类型。
5、按位取反 ~ 的注意事项
uint8_t a = 0x0F;
int b = ~a;
b 的值是 -16,而不是 0xF0(即 240)
为什么不能直接认为 b = 0xF0? 如果单纯看 8 位数据:
a是 8 位无符号整数,0x0F的二进制是0000 1111。如果对 8 位直接取反
~,结果确实是1111 0000,也就是0xF0。但是,C 语言的规则并非如此。
整型提升(Integer Promotion): 在 C 语言中,当对 char、short、uint8_t 等小于 int 的类型进行算术运算或位运算时,编译器会隐式地将它们提升为 int 类型(在常见的 32 位或 64 位系统中,int 通常是 32 位)。 这个内容在Chapter1 - 数据与变量中有提到。
~a 的执行过程如下:
(1)提升为 32 位 int:a 原本是 uint8_t,值为 0x0F。提升为 32 位 int 时,因为是无符号数,高位直接补 0
0000 0000 0000 0000 0000 0000 0000 1111 (32位下的 0x0F)(2)执行按位取反 ~:对上述 32 位数据全部取反(0变1,1变0)
1111 1111 1111 1111 1111 1111 1111 0000 (取反后的结果)此时,这依然是一个 32 位的 int 类型。
(3)赋值给 int b: b 也是 32 位的 int,它接收了上面这个全 1 结尾带 4 个 0 的二进制数 在计算机中,最高位是 1,代表这是一个负数,且以补码形式存储。
把这个补码转换回十进制原码: ① 补码:
1111 1111 1111 1111 1111 1111 1111 0000②减 1 得到反码:
1111 1111 1111 1111 1111 1111 1110 1111③除符号位外,按位取反得到原码:
000 0000 0000 0000 0000 0000 0001 0000④原码转十进制 符号位是负号,后面的值是 16,所以结果是 -16。
如果想得到 8 位取反结果(比如 0xF0 / 240): ①强制类型转换
uint8_t b = (uint8_t)~a; // 或者 uint8_t b = ~a; (赋值给 uint8_t 时会自动截断高24位)②按位与(掩码清除高位)
int b = ~a & 0xFF; // 把高 24 位全部清零,只保留低 8 位在 C 语言中,千万不要用 8 位或 16 位的思维去直接想象位运算的结果,因为它们会先被提升到 32 位的 int 参与计算。这种机制不仅影响 ~(按位取反),同样也影响 <<(左移)、>>(右移)以及加减乘除等运算。
四、位字段提取与修改
实际编程中,更常见的是一个整数中包含多个字段。 例如,一个 16 位通信协议头可能规定:
位范围 | 字段 | 宽度 |
|---|---|---|
bit 15~12 | 版本号 | 4 位 |
bit 11~8 | 消息类型 | 4 位 |
bit 7~4 | 状态码 | 4 位 |
bit 3~0 | 标志位 | 4 位 |
假设收到的数据为:
uint16_t header = 0xA35C;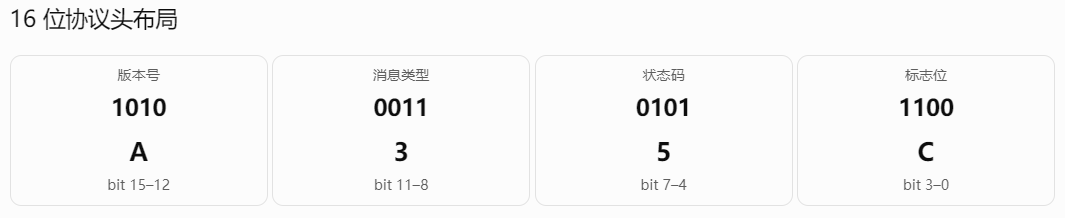
1、 提取指定字段
例如,我们想读取消息类型,也就是 bit 11~8。
uint16_t header = 0xA35C;

uint8_t type = (header >> 8) & 0x0F;
① header >> 8:右移 8 位,将目标字段移动到最低位。
原始值:1010 0011 0101 1100
右移8位:0000 0000 1010 0011
② (header >> 8) & 0x0F:通过掩码 0x0F 保留最低 4 位。
0000 0000 1010 0011
&
0000 0000 0000 1111
-------------------
0000 0000 0000 0011所以得到的结果为type == 3;
通用公式 要提取从 bit k 开始、宽度为 n 的字段:
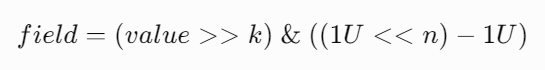
其中:
k是字段最低位的编号。n是字段宽度。(1U << n) - 1U用来生成 n 个连续的低位 1。
2、修改一个多位字段
假设要把 header 中的消息类型从 3 修改为 7,但不影响其他字段。
① 第一步:清除原有字段
header &= ~(0x0FU << 8);把 bit 11-8 这四个位置变成 0000,其他位置保持原样。
0x0FU:十六进制0x0F即二进制0000 1111(4个1);0x0FU << 8:向左移动8位,变成了0000 1111 0000 0000(定位到 bit 11-8);~取反操作:将上面的结果取反,得到掩码1111 0000 1111 1111(即0xF0FF)。这意味着除了 bit 11-8 是 0,其他全是 1。&=(按位与):
  原 header : 1010 0011 0101 1100 (0xA35C)
& 掩码      : 1111 0000 1111 1111 (0xF0FF)
-----------------------------------------
  结果      : 1010 0000 0101 1100 (0xA05C)
② 第二步:写入新值
header |= (7U << 8);把我们要设置的新值 7 放到 bit 11-8 的位置上。
7U:二进制是0000 0111。7U << 8:左移8位,变成了0000 0111 0000 0000(即0x0700)。|=(按位或):
  第一步结果 : 1010 0000 0101 1100 (0xA05C)
| 新值移位   : 0000 0111 0000 0000 (0x0700)
-----------------------------------------
最终结果 : 1010 0111 0101 1100 (0xA75C)合并操作:
header = (uint16_t)(
    (header & ~(0x0FU << 8)) |
    (7U << 8)
);
3、复合赋值与条件运算符
运算符 | 示例 | 含义 |
|---|---|---|
|
| 加法赋值 |
|
| 减法赋值 |
|
| 乘法赋值 |
|
| 除法赋值 |
|
| 取余赋值 |
|
| 按位与赋值 |
|= | a |= b | 按位或赋值 |
|
| 按位异或赋值 |
|
| 左移赋值 |
|
| 右移赋值 |
4、a += b 与 a = a + b 不完全等价
对于普通整数变量、没有特殊副作用的情况,它们通常产生相同结果。 但是从 C 语言规则来看,复合赋值左操作数只求值一次。 比如:
int arr[3] = {10, 20, 30};
int i = 0;

arr[i++] += 5;
执行后的结果为:
i == 1;
arr[0] == 15;
因为 arr[i++] 只被求值一次。
如果简单展开成:
arr[i++] = arr[i++] + 5;则不仅多次修改 i,还可能产生未定义行为。
复合赋值不能在所有情况下机械地替换成普通赋值形式。
5、条件运算符 ?:
条件运算符是 C 语言中唯一的三目运算符。 基本语法如下:
条件表达式 ? 表达式1 : 表达式2比如:
int a = 10;
int b = 20;

int max = (a > b) ? a : b;
// max == 20
判定方法如下:
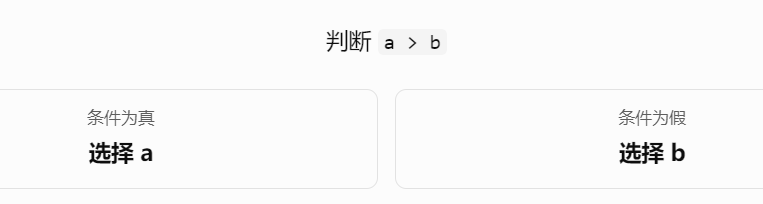
条件运算符具有短路求值特性
int a = 5;
int b = 10;

int x = (a > 0) ? ++a : ++b;只执行左边的++a,++b不会被执行。 最终结果为a == 6; b == 10; x == 6;
五、运算符优先级、结合性与求值顺序
概念 | 解决什么问题 | 举例 |
|---|---|---|
优先级(Precedence) | 运算符如何分组 | a + b * c |
结合性(Associativity) | 相同优先级的运算符如何分组 | a - b - c |
求值顺序(Evaluation Order) | 表达式各部分何时被计算 | f() + g() |
1、求值顺序
考虑:
int f(void);
int g(void);

int result = f() + g();+的左操作数是f()。+的右操作数是g()、 但C 语言不规定f()必须先于g()执行,编译器可以先调用f(),也可以先调用g()。 如果两个函数没有相互冲突的副作用,那么这种顺序差异通常不影响程序结果。 但是,如果函数会修改共享变量,情况就不同了。 示例:函数调用顺序
int count = 0;

int f(void)
{
    count++;
    return count;
}

int g(void)
{
    count++;
    return count;
}

int main(void)
{
    int result = f() + g();
}
这里 f() 和 g() 的调用顺序不确定。 但这段代码并不因为两个函数都修改 count 就自动成为未定义行为。
C 语言规定,不同函数执行中的操作不会像一个表达式中未排序的两个 i++ 那样任意交错执行。因此这里两个函数调用的==执行顺序未指定,但它们会依次完成==。
调用顺序一共有两种可能:
顺序 | f() 返回 | g() 返回 | result |
|---|---|---|---|
先 f 后 g | 1 | 2 | 3 |
先 g 后 f | 2 | 1 | 3 |
这与下面的代码有本质区别:
int i = 0;
int result = i++ + i++;
这里两个 i++ 是未排序的副作用,属于未定义行为。
2、三个行为类别
类别 | 含义 | 示例 |
|---|---|---|
定义明确的行为 | C 标准规定结果或规则 |
|
未指定行为 | 标准允许多种选择,不要求固定选择 |
|
未定义行为 | 标准不对结果提供保证 |
|
3、序列关系(Sequencing)
关系 | 含义 |
|---|---|
Sequenced before | A 的求值先于 B 的求值 |
Unsequenced | A、B 之间没有规定的顺序关系 |
Indeterminately sequenced | A、B 必然有先后,但先后次序未指定 |
逗号运算符保证顺序
int a = 0;

int b = (a = 5, a + 2);
逗号运算符会先求值左侧表达式,再求值右侧表达式。 得到的结果是:a = 5; b = 7; 但需要注意:函数参数之间的逗号只是分隔符,不是逗号运算符。
(1)工程实践中应当主动拆分复杂表达式 考虑:
uint32_t value = read_sensor() + update_counter();如果两个函数相互独立,这样写可能没有任何问题。 但如果希望严格规定执行顺序,最好写成:
uint32_t sensor = read_sensor();
uint32_t counter = update_counter();

uint32_t value = sensor + counter;
这样代码不仅更容易阅读,也能明确保证先执行 read_sensor(),再执行 update_counter()。
(2)未定义行为和未指定求值顺序 考虑:
int count = 0;

int next(void)
{
return ++count;
}

void show(int a, int b);

int main(void)
{
show(next(), next());
}
这段代码属于“未指定求值顺序”
未指定求值顺序:语言标准提供了几种合法的执行方式(比如先算 A 或者先算 B),程序是合法的,结果也是可预期的(只是可能有两个不同的合法结果)。
未定义行为:语言标准对此没有任何规定,任何结果都是可能的,程序甚至可能直接崩溃。
C/C++ 标准有一条铁律:在两个序列点(Sequence Point)之间,同一个变量只能被修改一次,且不能既被读取又被修改。
但在C11/C17中引入了“序列规则(Sequencing rules)”,严格规定了函数调用的参数的求值顺序是不确定定序(Indeterminately Sequenced)。 所以有可能是show(1, 2),也可能是show(2, 1),但最后的结果是一致的。 因此,求值顺序未指定,并不意味着程序存在未定义行为。